Deploy vs release: a disciplina operacional essencial da engenharia moderna em 2026
Durante anos, a engenharia de software tratou as palavras 'deploy' e 'release' como sinônimos intercambiáveis. O pipeline de CI/CD terminava, os novos artefatos substituíam os antigos nos clusters de produção e, naquele exato segundo, a funcionalidade estava exposta a 100% dos usuários finais. Se houvesse uma falha de concorrência ou um gargalo em queries de banco de dados, o impacto era imediato, catastrófico e generalizado.
Essa mentalidade unificada transforma qualquer publicação de código em um evento de alto estresse. Equipes inteiras passam a agendar janelas de manutenção nas madrugadas de sexta-feira ou no final de semana, tentando diminuir o blast radius de incidentes em horários de pico. Trata-se de uma abordagem frágil, que desestimula deploys frequentes e desacelera o time to market da empresa.
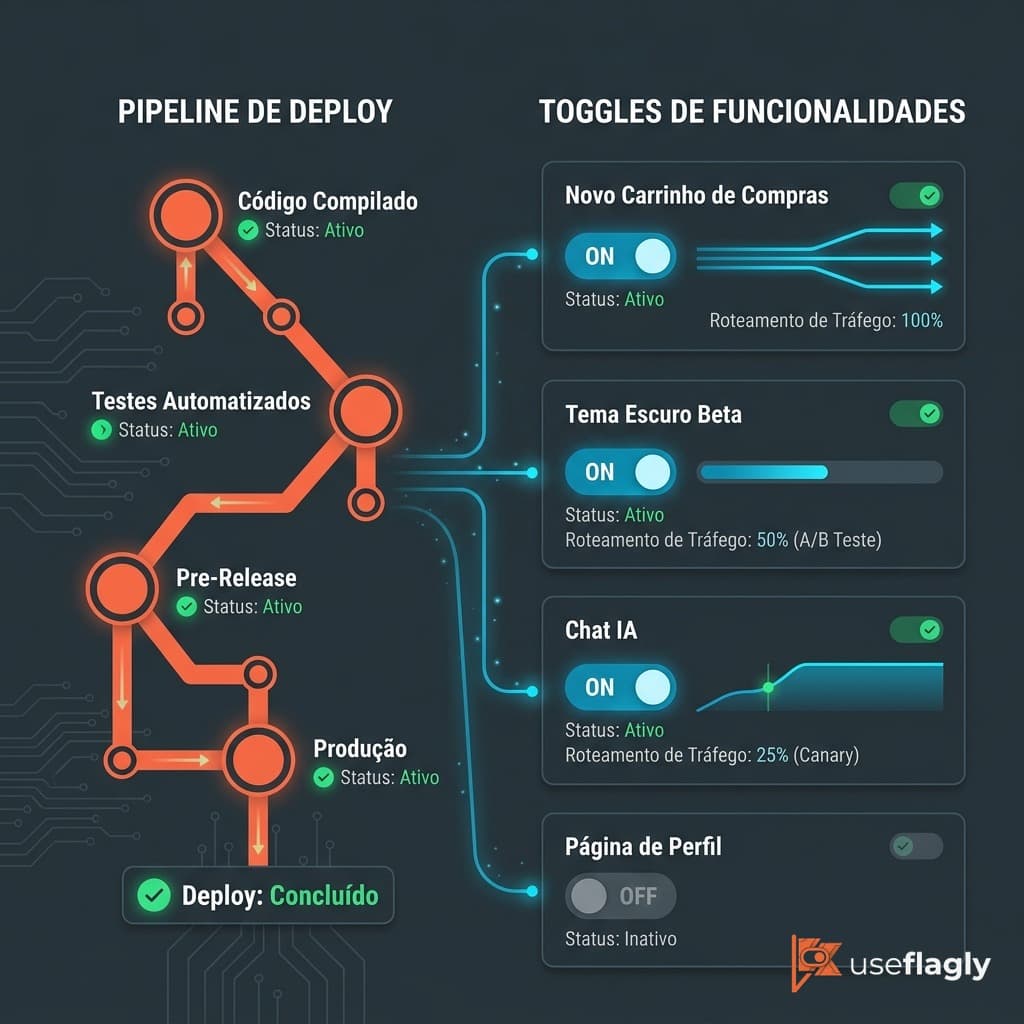
A engenharia moderna estabelece uma linha divisória rigorosa: deploy é um evento estritamente técnico de transferência e validação de artefatos de infraestrutura, enquanto release é uma decisão de negócio orientada à experiência do usuário. Quando sua arquitetura não separa essas duas etapas, cada linha de código enviada ao cluster vira uma aposta desnecessária contra a estabilidade do sistema.
Desmistificando os maiores mitos do mercado
❌ MITO: Deploy e Release são a mesma coisa e acontecem no mesmo instante do pipeline.
✅ REALIDADE: Deploy é a ação de empacotar código, passar por testes automatizados, construir imagens de contêiner e posicionar esses binários em execução nos servidores de produção. O código passa a existir na infraestrutura, mas isso não significa que ele deva ser executado pelos clientes finais.
Release, por outro lado, é o ato deliberado de disponibilizar o comportamento novo para segmentos específicos ou para a totalidade dos usuários. Essa liberação acontece dinamicamente por meio de Feature Flags e regras de Remote Config avaliadas em runtime, permitindo que o time teste o comportamento real do software em produção sem expor a interface ou o fluxo crítico ao público geral.
❌ MITO: Ambientes de Staging idênticos a Produção eliminam a necessidade de Feature Flags.
✅ REALIDADE: Nenhum ambiente de homologação ou staging replica com exatidão a volumetria, a concorrência assíncrona, a diversidade de dados legados e a latência de rede do ambiente produtivo. Confiar cegamente que um teste verde em staging garante estabilidade total é uma das principais causas de indisponibilidade em sistemas distribuídos.
Ao manter as funcionalidades protegidas por toggles desligados por padrão, os engenheiros conseguem validar o comportamento real do software diretamente em produção. É possível liberar o acesso apenas para usuários internos ou contas de teste, avaliando o comportamento das queries e o consumo de memória sob a carga real da infraestrutura antes da liberação pública.
❌ MITO: Fazer rollback de infraestrutura via pipeline de CI/CD é a forma mais rápida de conter falhas graves.
✅ REALIDADE: Quando uma falha crítica surge após um release conjunto, disparar um rollback de infraestrutura costuma levar de 15 a 45 minutos. Esse processo exige disparar novos jobs no pipeline, reconstruir ou baixar imagens de contêiner antigas, realizar health checks e redistribuir o tráfego nos pods, período em que o cliente continua enfrentando erros.
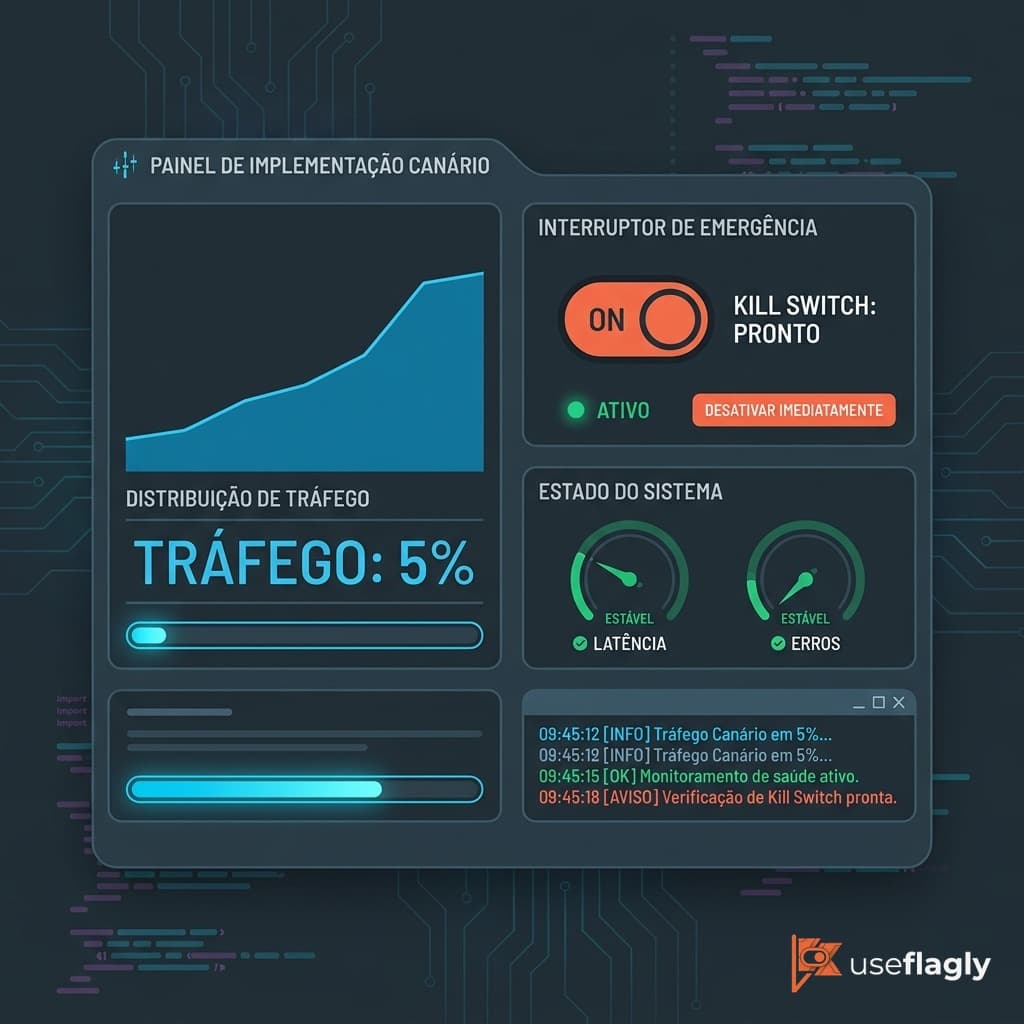
Em contraste, utilizar um Kill Switch gerenciado por Feature Flags corta o blast radius instantaneamente. A funcionalidade defeituosa é desativada no painel de controle em milissegundos via edge computing, sem necessidade de reverter commits, sem rodar pipelines de deploy e sem reiniciar instâncias do cluster.
Por que esses mitos custam caro para as empresas
A insistência em amarrar o deploy à liberação de funcionalidades gera um custo oculto estrondoso para as operações de tecnologia. O primeiro sintoma é a proliferação de branches de longa duração no Git. Desenvolvedores passam semanas isolados sem sincronizar seu código na branch principal por medo de que funcionalidades inacabadas vazem para o cliente final, resultando no conhecido 'merge hell' e em semanas perdidas resolvendo conflitos.
O segundo impacto direto recai sobre a frequência de entrega e os indicadores operacionais da equipe. Sem a capacidade de desligar recursos em tempo de execução, os times diminuem o ritmo de entrega e agrupam centenas de alterações em deploys gigantescos e arriscados. Quando o erro acontece, identificar a linha exata que degradou o banco de dados vira uma tarefa de horas de depuração em salas de crise sob pressão direta da diretoria.
Além do desgaste humano e do risco de churn de usuários insatisfeitos com telas de erro, muitas equipes tentam mitigar o problema adotando plataformas internacionais legadas com preços cotados em dólar (USD). A organização acaba surpreendida pela volatilidade cambial, taxas de IOF imprevisíveis e suporte distante em outros fusos horários, quando na realidade precisava apenas de uma disciplina operacional sólida baseada em toggles de baixa latência nativos no mercado nacional.
O que fazer na prática: as melhores diretrizes
-
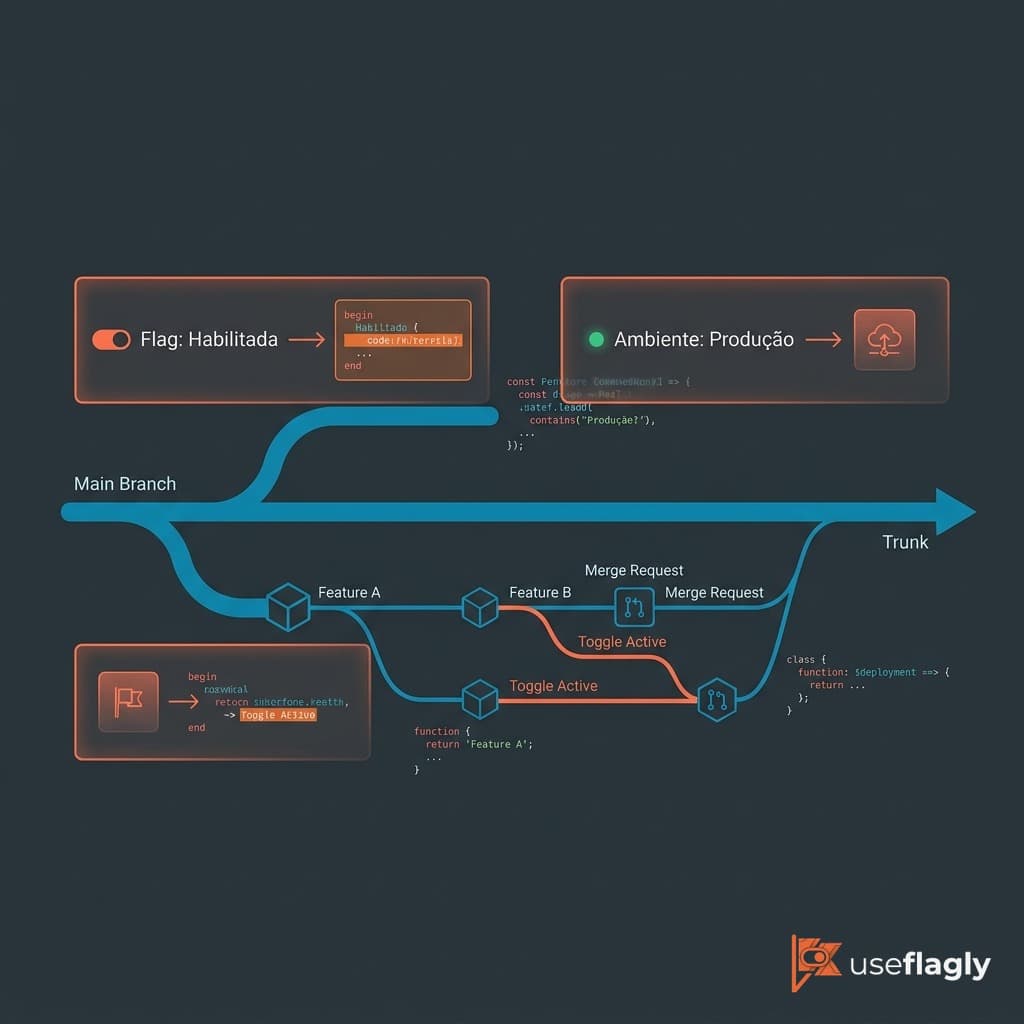
Adote Trunk-Based Development com Feature Flags: Em vez de manter branches abertas por semanas aguardando aprovações manuais, faça commits diários na branch principal. Proteja os novos blocos de código com condicionais gerenciadas por toggles mantidos desligados por padrão. Dessa forma, seu código é integrado continuamente, os testes unitários rodam no pipeline e a entrega técnica ocorre sem impacto na experiência de uso.
-
Implemente Canary Releases e Rollouts Percentuais: Abandone o modelo de liberação 'tudo ou nada'. Utilize flags dinâmicas para liberar recursos gradualmente: comece com 1% da base de usuários ou apenas colaboradores internos. Monitore métricas de telemetria, consumo de CPU e taxa de erros HTTP 5xx. Conforme a estabilidade do sistema se confirma sob tráfego real, expanda o percentual de liberação com autonomia e segurança.
-
Padronize a Gestão e Higienização do Ciclo de Vida dos Toggles: Toggles de liberação rápida não devem se tornar débito técnico perpétuo. Estabeleça como regra de engenharia remover as instruções condicionais do código-fonte assim que a funcionalidade estiver 100% consolidada e estável em produção. Mantenha no sistema apenas flags permanentes, como Kill Switches operacionais e configurações remotas de resiliência.
Separe o deploy do código da liberação de produto agora mesmo. Crie sua conta gratuita no UseFlagly e comece hoje no plano Hobby do UseFlagly em https://useflagly.com.br sem precisar cadastrar cartão de crédito, aproveitando faturamento em Reais e suporte técnico especializado feito no Brasil.
Pronto para testar Feature Flags na prática?
Crie sua conta grátis no UseFlagly em 2 minutos e comece a controlar lançamentos, testes A/B e kill-switches sem precisar de novo deploy.
✓ 100% Gratuito no Plano Hobby • 25.000 requisições inclusas • Sem cartão de crédito