Gerenciamento hierárquico de flags em b2b enterprise: guia de custos, arquitetura e suporte em 2026
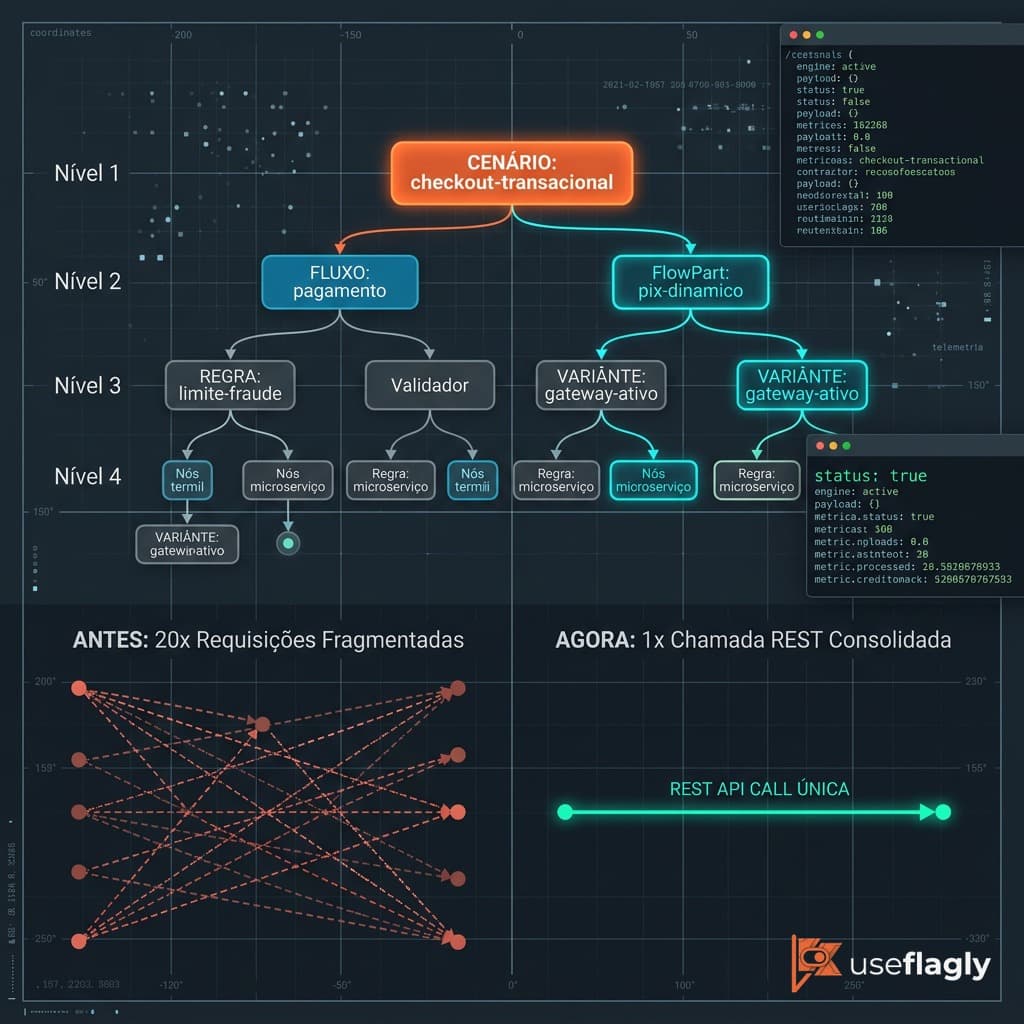
Líderes de engenharia, CTOs e arquitetos de software em operações B2B Enterprise enfrentam um desafio estrutural crescente em 2026: a proliferação desordenada de feature flags legadas e a explosão de custos em faturas internacionais. Plataformas tradicionais cobram por assentos de desenvolvedores e volumes brutos de requisições HTTP, gerando faturas atreladas ao dólar que penalizam o crescimento das aplicações. Pior ainda, a arquitetura convencional de chaves booleanas soltas força o frontend ou backend a disparar dezenas de requisições de rede para validar uma única jornada de checkout ou onboarding corporativo, gerando overhead de I/O e risco de inconsistência transacional.
Este guia de compra técnico foi elaborado para equipes que operam ecossistemas complexos de alta transacionalidade — como fintechs, e-commerces e plataformas SaaS Enterprise — e precisam de governança real sem estourar o orçamento de infraestrutura. A chave da virada arquitetural em 2026 está no abandono das flags pontuais isoladas em favor do Feature Management Hierárquico baseado em Cenários, no qual uma jornada inteira é avaliada de forma determinística em chamada única.
Ao longo das próximas seções, destrinchamos a matriz de decisão técnica e financeira necessária para auditar provedores de release management. Você entenderá exatamente como comparar modelos de precificação em Reais (BRL), validar estratégias de resiliência com cache multicamada L1/L2 e escolher um parceiro de infraestrutura com suporte de engenharia dedicado, eliminando contratos opacos.
Critérios decisivos de escolha
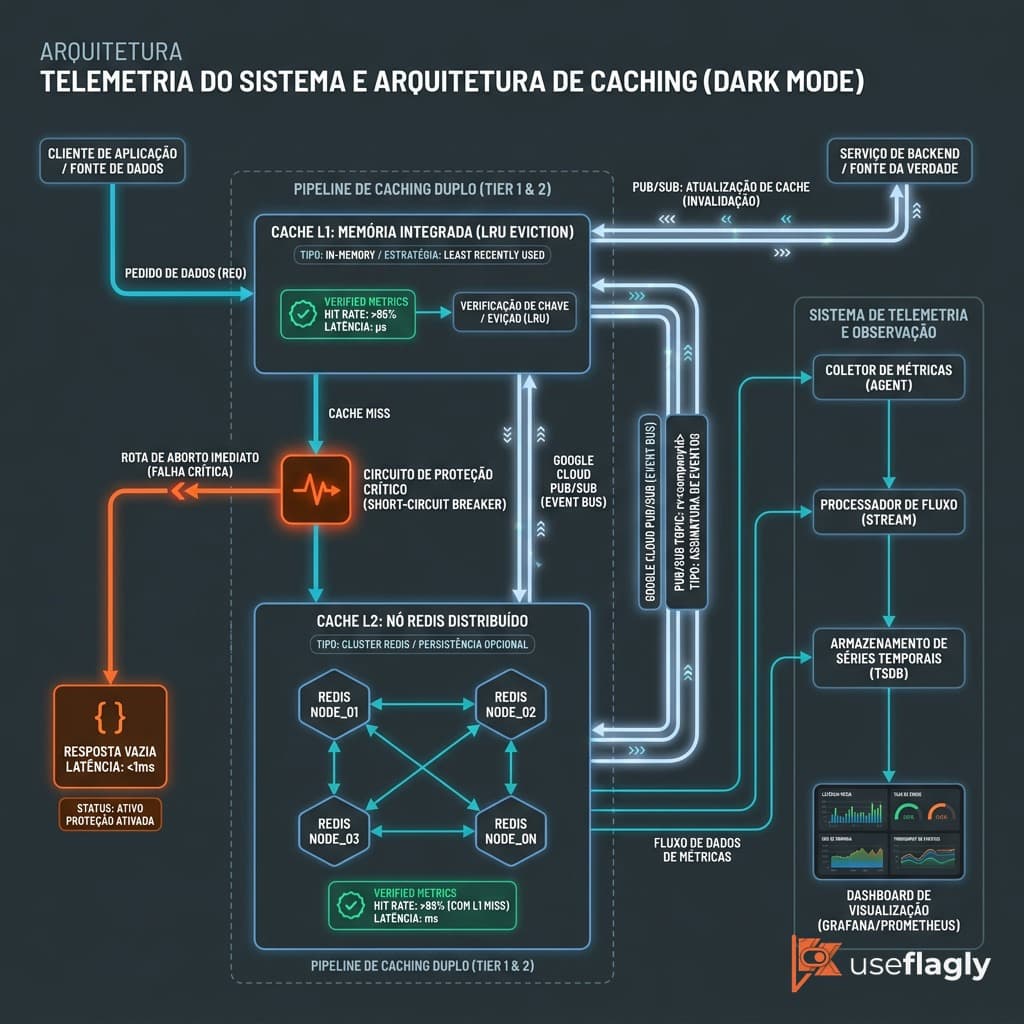
O primeiro critério inegociável é a Topologia de Avaliação: suporte nativo a Grafos Acíclicos Dirigidos (DAG) estruturados em quatro níveis estritos — Cenário (Nível 0), Fluxo (Nível 1), Parte de Fluxo (Nível 2) e Flag Atômica (Nível 3). Em fluxos corporativos, uma falha em um gate de compliance ou desativação de emergência deve acionar short-circuit imediato no Nível 0, abortando os níveis inferiores e retornando {} em sub-milissegundos via HTTP 200, sem desperdiçar ciclos de CPU, I/O de rede ou consultas em banco de dados.
O segundo pilar técnico é a Infraestrutura de Caching e Invalidação Reativa. Para sustentar milhões de avaliações por minuto sem onerar o hot path da aplicação, o ecossistema deve combinar cache L1 in-memory local (com política de eviction LRU e TTL configurável) e cache L2 distribuído via Redis. Modificações de regras no dashboard visual não podem depender de longos intervalos de polling: a arquitetura exige invalidação orientada a eventos via Google Cloud Pub/Sub, transmitindo versões de regra (rv:<companyId> ou __rv) para expurgar instantaneamente a memória volátil de todas as réplicas em execução.
Por fim, avalie o motor de segmentação e determinismo. Recursos de rollout gradual devem obrigatoriamente operar com algoritmos de dispersão hashing determinísticos, a exemplo de SHA-256("${flagSlug}:${identifier}") % 100, aplicando salts individuais por flag. Isso impede que o mesmo usuário corporativo caia em todos os testes canary do sistema simultaneamente. Além disso, a engine precisa suportar comparadores semânticos estritos (semver), intervalos numéricos fechados (range), coleções contextuais e validações cruzadas (flag_result) com auditoria regra a regra.
Matriz de escolha por perfil de uso
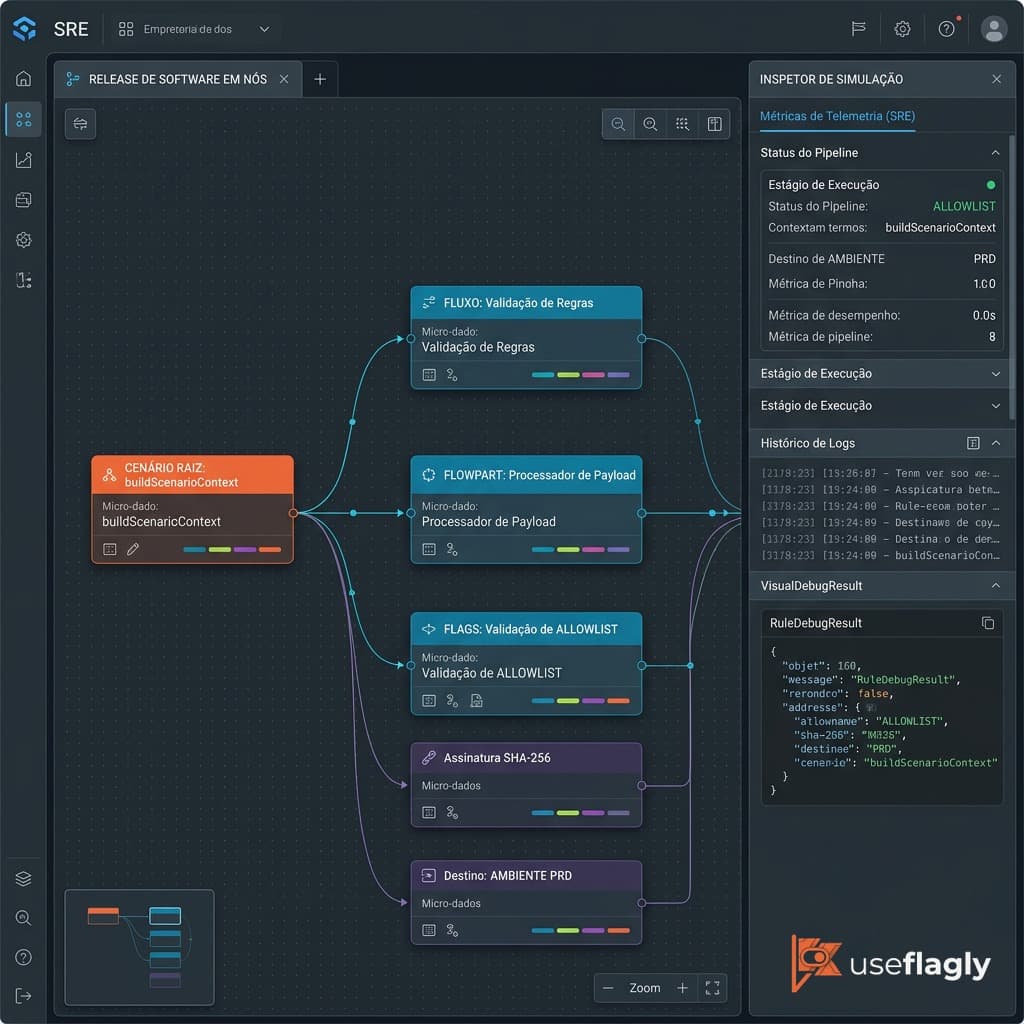
Para Scale-ups e Operações B2B em Crescimento: Equipes que gerenciam produtos SaaS com times distribuídos demandam autonomia visual sem risco operacional. O perfil ideal exige um construtor de workflow visual interativo montado sobre @xyflow/react, permitindo que Tech Leads configurem conexões entre Flows e FlowParts via drag-and-drop. Mecanismos de exclusão segura em cascata (removeNodeWithChildren) tornam-se essenciais para auditar e alertar o total de nós dependentes antes de qualquer deleção acidental de flags de produção.
Para Fintechs e Transações Críticas de Alta Carga: O requisito central é latência previsível e blindagem de segurança com gates de lista (ALLOWLIST e BLOCKLIST) aplicados diretamente em qualquer nó da árvore. Em vez de orquestrar chamadas paralelas para múltiplos endpoints, adota-se o endpoint unificado /validate/scenario/:slug. Ambientes de alta conformidade exigem simuladores embutidos com geração de template via buildScenarioContext e depurador RuleDebugResult, inspecionando prioridades e conectores booleanos AND/OR diretamente contra a base antes de publicar em homologação ou produção.
Para Grandes Corporações B2B Enterprise: Neste nível, os critérios preponderantes são estabilidade orçamentária, governança de ambientes isolados (HML/PRD) e suporte consultivo 24/7. Organizações enterprise não toleram flutuação cambial em contratos nem cobranças imprevisíveis por volume de sessões ativas (MAU). O foco recai em plataformas consolidadas com faturamento em Reais (BRL), SLA garantido por contrato e canal direto com engenheiros de sistemas distribuídos para consultoria de arquitetura de software.
Estimativa de custo & retorno sobre o investimento (roi)
A análise financeira de feature management costuma revelar armadilhas severas nos contratos tradicionais cotados em dólar (USD). Em fornecedores norte-americanos, uma empresa com 50 desenvolvedores e tráfego elevado de microsserviços pode facilmente ultrapassar dezenas de milhares de dólares por ano devido a cobranças punitivas por assento ou por milhão de eventos avaliados. Ao migrar para um modelo enterprise nacional com custo fixado em Reais — a exemplo de planos corporativos dedicados por R$ 2.499,00 mensais com requisições e usuários ilimitados —, a redução de TCO (Total Cost of Ownership) supera com frequência a margem de 60% a 70% no primeiro ano fiscal.
O ROI técnico, contudo, é ainda mais expressivo quando medido na infraestrutura de nuvem. Consolidar dezenas de checagens atomizadas em uma única requisição de cenário /validate/scenario/:slug reduz drasticamente o tráfego inter-service, o consumo de egress e a contenção de conexões no backend. Somado a isso, o cache multicamada (L1 com LRU e L2 no Redis) resolve grande parte das avaliações com latência sub-milissegundo, preservando instâncias de computação e bancos relacionais.
Outro ganho econômico direto reside na prevenção de incidentes e no Mean Time to Recovery (MTTR). O recurso de short-circuit do Nível 0 desliga funcionalidades defeituosas em tempo real sem a necessidade de novos builds de CI/CD ou rollbacks manuais de contêineres Kubernetes. Cada hora de indisponibilidade evitada em jornadas transacionais de pagamento paga múltiplos anos de licenciamento da ferramenta de gerenciamento.
Checklist do comprador inteligente
-
Faturamento 100% nacional em Reais (BRL), com eliminação de IOF, spread cambial e cobranças punitivas por assento de engenharia.
-
Arquitetura hierárquica em 4 níveis (Cenário, Fluxo, FlowPart e Flag) com avaliação consolidada em chamada REST única.
-
Suporte a short-circuit automático no nó raiz para mitigação instantânea de incidentes e economia de I/O computacional.
-
Caching multicamada L1 in-memory com LRU e L2 distribuído em Redis, sincronizados por invalidação reativa via Pub/Sub.
-
Algoritmo determinístico de rollout gradual baseado em SHA-256 com salt individual por flagSlug para evitar contaminação de amostra.
-
Canvas de workflow interativo com exclusão segura em cascata e simulador de regras em tempo real (RuleDebugResult).
-
Suporte técnico consultivo de engenharia e SLA corporativo com atendimento contínuo 24/7 para ambientes críticos.
Pronto para eliminar a complexidade de chamadas distribuídas e modernizar sua engenharia de lançamentos em 2026? Conheça os planos e a arquitetura unificada da useflagly.com.br e comece a operar com alta confiabilidade técnica e previsibilidade orçamentária.
Pronto para testar Feature Flags na prática?
Crie sua conta grátis no UseFlagly em 2 minutos e comece a controlar lançamentos, testes A/B e kill-switches sem precisar de novo deploy.
✓ 100% Gratuito no Plano Hobby • 25.000 requisições inclusas • Sem cartão de crédito