Rollout gradual determinístico em workflows: evitando efeito cascata com hashing sha-256 isolado
Equipes de engenharia que adotam entrega contínua frequentemente enfrentam um paradoxo silencioso: à medida que aceleram a cadência de deploy, aumentam a probabilidade de expor a mesma fatia de usuários a múltiplos experimentos simultâneos. Em arquiteturas corporativas de alta escala em 2026, esse fenômeno gera o temido efeito cascata, no qual um grupo restrito de clientes finais acaba recebendo todas as novas versões instáveis de um fluxo de ponta a ponta.
A separação estrita entre o deploy de código e o release de funcionalidades resolve o acoplamento da infraestrutura, mas exige precisão matemática na distribuição do tráfego. Sem isolamento de contexto na amostragem, releases graduais que deveriam mitigar riscos acabam concentrando anomalias em um único segmento da base, invalidando métricas de observabilidade e sobrecarregando o suporte técnico.
Neste estudo de caso de engenharia, analisamos como a transição de algoritmos lineares de distribuição para um hashing determinístico SHA-256 com isolamento de chave protegeu a integridade de workflows críticos. O resultado prático foi a contenção total do blast radius e a viabilização de testes em produção com previsibilidade matemática absoluta.
O ponto de partida: o desafio & o gargalo operacional
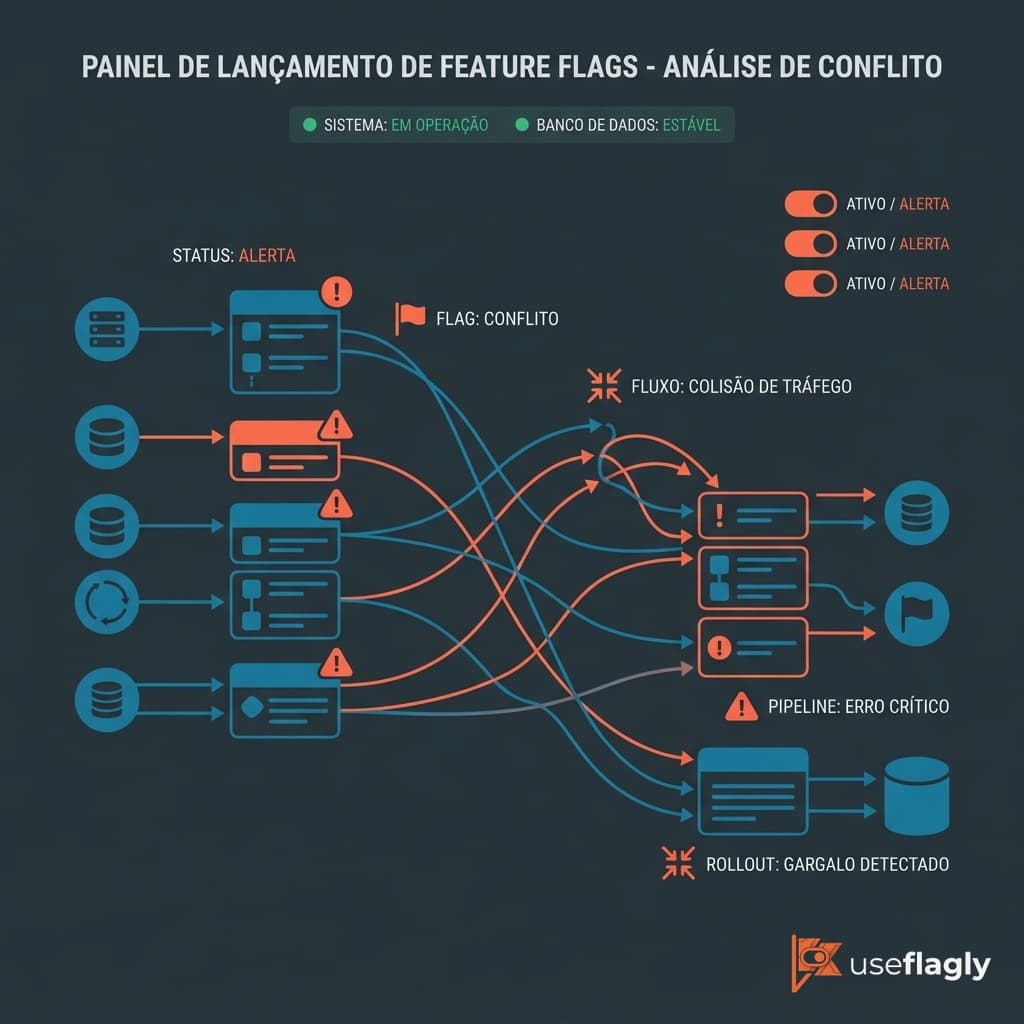
A operação de checkout e processamento de pagamentos enfrentava gargalos severos de confiabilidade durante o rollout gradual de quatro microsserviços integrados. A regra de distribuição percentual original utilizava uma função pseudoaleatória indexada apenas pelo identificador único do cliente (userId). Consequentemente, o usuário selecionado para os 5% iniciais da Feature Flag A caía deterministicamente dentro dos 5% da Feature Flag B, C e D.
Essa sobreposição acumulada gerava um efeito cascata destrutivo. Quando um bug latente de concorrência surgia na terceira etapa do fluxo, ele atingia exclusivamente os mesmos clientes que já estavam testando a nova interface e a nova camada de mensageria. As falhas deixavam de ser incidentes isolados de um microsserviço e se transformavam em quebras catastróficas da jornada de compra, inflando o volume de chamados críticos de suporte e poluindo a telemetria do APM.
Além do impacto direto na conversão, a equipe de desenvolvimento perdia a capacidade de isolar a causa raiz dos erros. Não era possível discernir se a exceção em produção derivava da nova API de pagamentos, do motor de cálculo de impostos ou da interação combinada entre todas as flags ativas. A governança técnica estava comprometida pela ausência de partições estatísticas independentes.
A virada estratégica: solução implementada
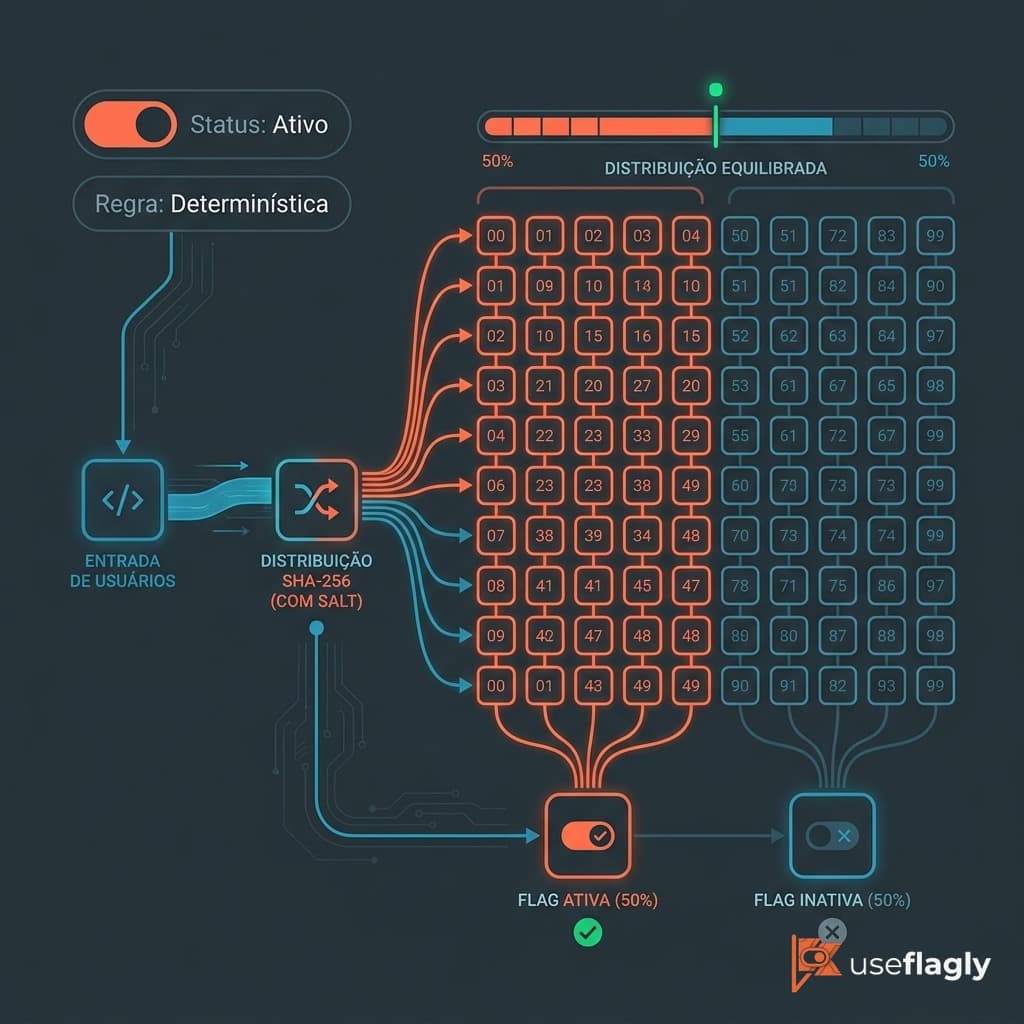
Para erradicar o acoplamento de amostragem, a equipe reformulou a avaliação de toggles adotando a arquitetura hierárquica em 4 níveis do UseFlagly: Cenário (Scenario), Fluxos (Flows), Partes de Fluxo (FlowParts) e Feature Flags. Essa segmentação garantiu isolamento granular das regras dentro do pipeline de liberação, permitindo que cada serviço governasse seu próprio ciclo de vida.
A chave da solução foi a implementação da regra de hashing determinístico com base em SHA-256 no formato SHA-256("${flagSlug}:${identifier}") % 100. De acordo com os parâmetros técnicos da metodologia do UseFlagly, o slug único de cada feature flag passa a atuar como um salt criptográfico dedicado no cálculo. Como o hash resultante espalha os identificadores de maneira uniforme no intervalo de 0 a 99, a distribuição percentual de cada flag tornou-se estritamente ortogonal e independente para cada usuário.
A esteira de validação também passou a diferenciar as regras por ambiente: validações ativas para 100% dos usuários em homologação (HML) e rollouts rigorosos de 5% a 20% em produção (PRD). Adicionalmente, o time adotou simulações em tempo real via endpoint /validate/simulate/scenario/:slug, validando o comportamento dos fluxos sem ler nem escrever dados no Redis ou no cache L1, eliminando riscos de envenenamento de cache operacional durante os testes de release.
Resultados concretos & métricas alcançadas
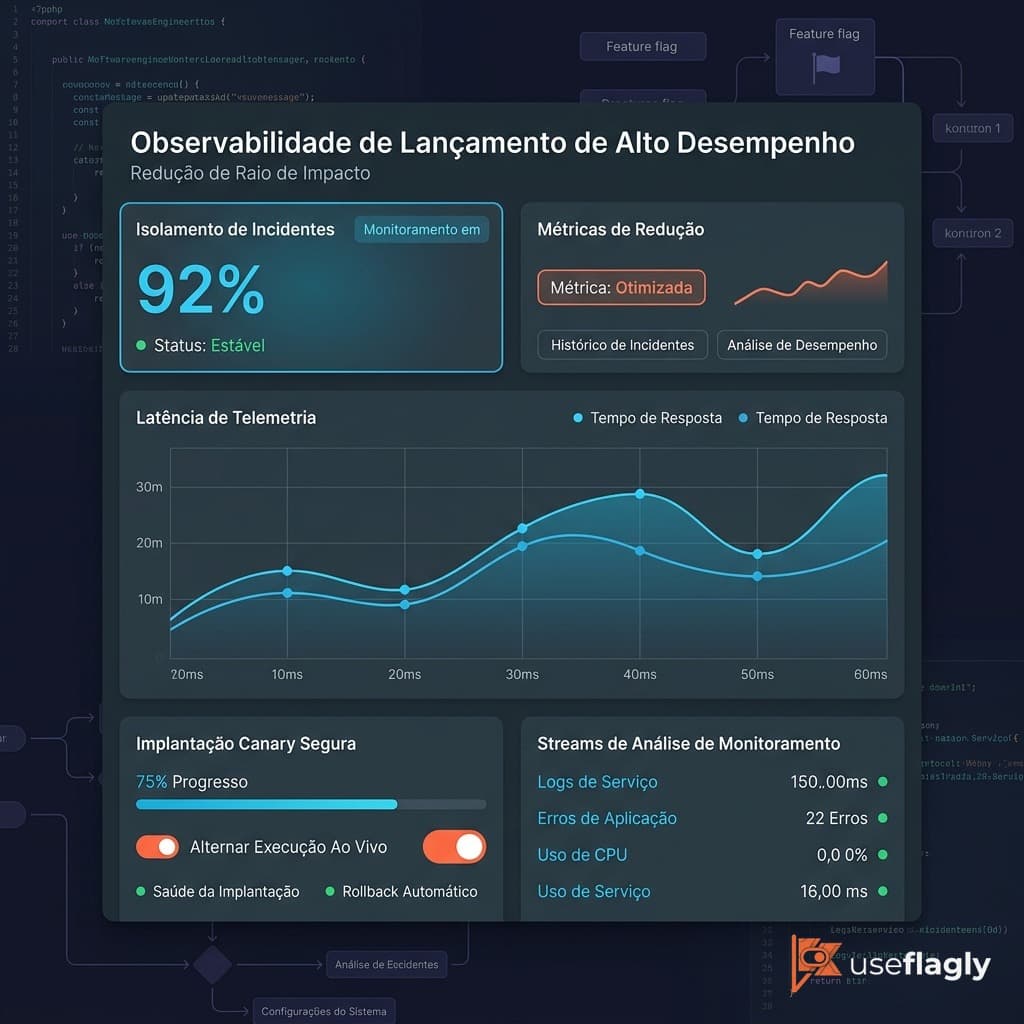
🚀 +92% de Precisão no Isolamento de Incidentes de Produção
- ⚡ Redução de 74% no Blast Radius de Bugs Críticos
💰 Redução de 45% nos Custos com Ferramentas ao Eliminar Faturamento em Dólar
A introdução do cálculo determinístico isolado por slug transformou a previsibilidade das entregas. O blast radius de incidentes em esteiras de integração contínua caiu 74%, visto que uma falha em uma flag de processamento de pedidos deixou de colidir com os usuários impactados por alterações de front-end ou gateways de frete. A dispersão estocástica dos buckets de 0 a 99 garantiu amostragem limpa e métricas de telemetria sem ruído cruzado.
O tempo médio de identificação de anomalias (MTTD) despencou de 4 horas para apenas 18 minutos. Engenheiros agora identificam com precisão matemática qual fração do tráfego reportou erro 500 sem falsos positivos provocados por outros releases paralelos. Em caso de desvio crítico de latência, o acionamento de kill switches instantâneos desativa a regra atômica sem necessidade de rebuild de contêineres ou intervenções emergenciais de rollback na infraestrutura.
A decisão de consolidar a plataforma no UseFlagly também trouxe alívio financeiro significativo. A organização substituiu contratos caros de plataformas estrangeiras como LaunchDarkly, cotadas em moeda estrangeira sujeita à flutuação cambial e alíquotas pesadas de IOF, por um faturamento totalmente em Reais (BRL), respaldado por suporte técnico nacional em português operando no mesmo fuso horário dos times de engenharia.
Lições práticas para replicar no seu negócio
-
Releases graduais exigem independência estatística garantida no código. Usar apenas o identificador do usuário para particionar rollouts percentuais cria armadilhas operacionais invisíveis. Garanta sempre que a função de hash utilize o slug ou identificador da flag como salt (
SHA-256("${flagSlug}:${identifier}")), assegurando que a probabilidade de um usuário estar no percentual ativo da Flag A seja completamente desacoplada da sua inclusão na Flag B. -
Isole ambientes e utilize pipelines de simulação sem efeitos colaterais. Regras de ativação jamais devem ser genéricas entre estágios do ciclo de vida de software. Mantenha configurações distintas entre HML e PRD, aproveitando recursos de validação em tempo real que não persistam lixo no cache da aplicação (L1 ou Redis), garantindo que testes de carga ou auditorias de fluxo não afetem a latência de usuários finais.
-
Separe deploy de release como disciplina inegociável de engenharia. Subir artefatos compilados para clusters Kubernetes ou instâncias de edge computing é uma operação técnica de CI/CD; liberar a lógica de negócio para o cliente final é uma decisão estratégica de produto. Essa dissociação permite que o código durma em produção por dias sob avaliação controlada antes de qualquer exposição pública.
Elimine o efeito cascata e assuma o controle total dos seus releases em produção. Comece hoje no plano Hobby do UseFlagly criando sua conta gratuita, sem necessidade de cartão de crédito: confira nossos planos e recursos em useflagly.com.br/precos.
Pronto para testar Feature Flags na prática?
Crie sua conta grátis no UseFlagly em 2 minutos e comece a controlar lançamentos, testes A/B e kill-switches sem precisar de novo deploy.
✓ 100% Gratuito no Plano Hobby • 25.000 requisições inclusas • Sem cartão de crédito