Testes de backend em produção sem contaminação de base: governança com contexto de usuário e rollout direcionado em 2026
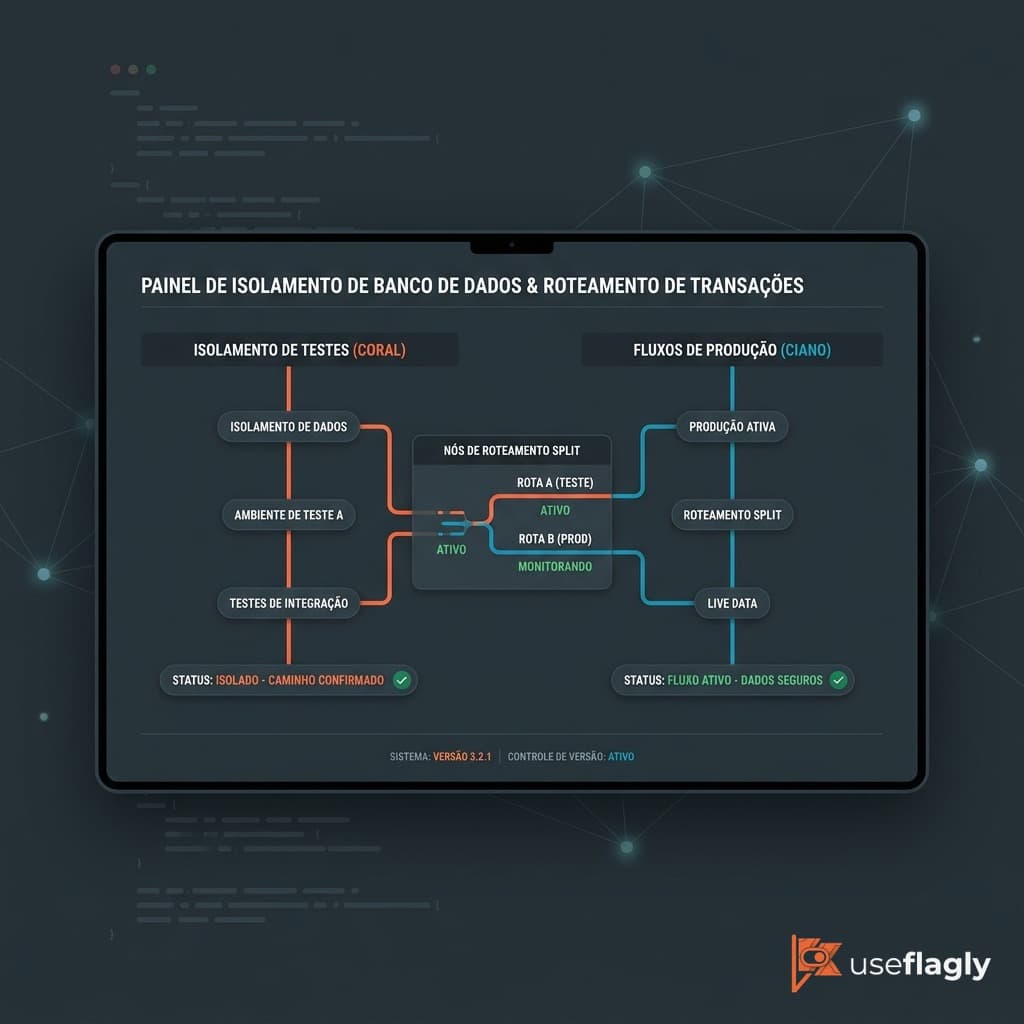
Validar rotinas críticas de backend diretamente no ambiente de produção sempre representou um dilema severo para times de engenharia de software: como atestar o comportamento real de novas queries, integrações de pagamento ou mutações transacionais complexas sem poluir tabelas operacionais ou impactar usuários legítimos? Em 2026, com arquiteturas distribuídas e bancos de dados altamente acoplados a barramentos de mensageria, manter ambientes de staging perfeitamente espelhados tornou-se financeiramente inviável e tecnicamente ineficiente.
A resposta definitiva para essa fricção reside na dissociação completa entre deploy de código e release de regras de negócio. Ao enviar novos binários e artefatos compilados para a infraestrutura mantendo a execução silenciada sob toggles granulares, a engenharia elimina suposições e ganha a capacidade de acionar fluxos de execução apenas quando critérios contextuais rigorosos forem atendidos.
Este estudo de caso documenta como uma operação transacional de alto volume reestruturou seu pipeline de backend utilizando a infraestrutura do UseFlagly. A equipe substituiu deploys noturnos arriscados por uma esteira contínua com rollouts direcionados por contexto de requisição, blindando os dados de produção contra qualquer vazamento de estado inconsistente.
O ponto de partida: o desafio & o gargalo operacional
A arquitetura do sistema contava com microsserviços em Go e Node.js processando centenas de requisições por segundo contra um cluster transacional particionado. Toda alteração na camada de persistência ou na lógica de agregação exigia janelas de manutenção de madrugada. Mesmo após semanas de testes sintéticos em ambientes de homologação, erros de concorrência, deadlocks em índices secundários e discrepâncias em limites de rate limit só se manifestavam no momento do tráfego real.
O gargalo operacional se agravava pelo risco constante de poluição de dados: se um teste executado em produção gravasse registros sem rastreamento de isolamento, filas assíncronas disparavam webhooks externos, emails transacionais para clientes reais e inconsistências fiscais irreversíveis. A equipe enfrentava um blast radius desproporcional para cada nova funcionalidade colocada no ar.
Além da insegurança técnica, a dependência de plataformas legadas de Feature Flags estrangeiras trazia barreiras contratuais severas. A cobrança em dólar sujeita a flutuações cambiais imprevisíveis e as taxas adicionais de IOF inviabilizavam a expansão do monitoramento de flags para todos os microsserviços, forçando os desenvolvedores a criar toggles caseiros e hardcoded que acumulavam dívida técnica crônica.
A virada estratégica: solução implementada
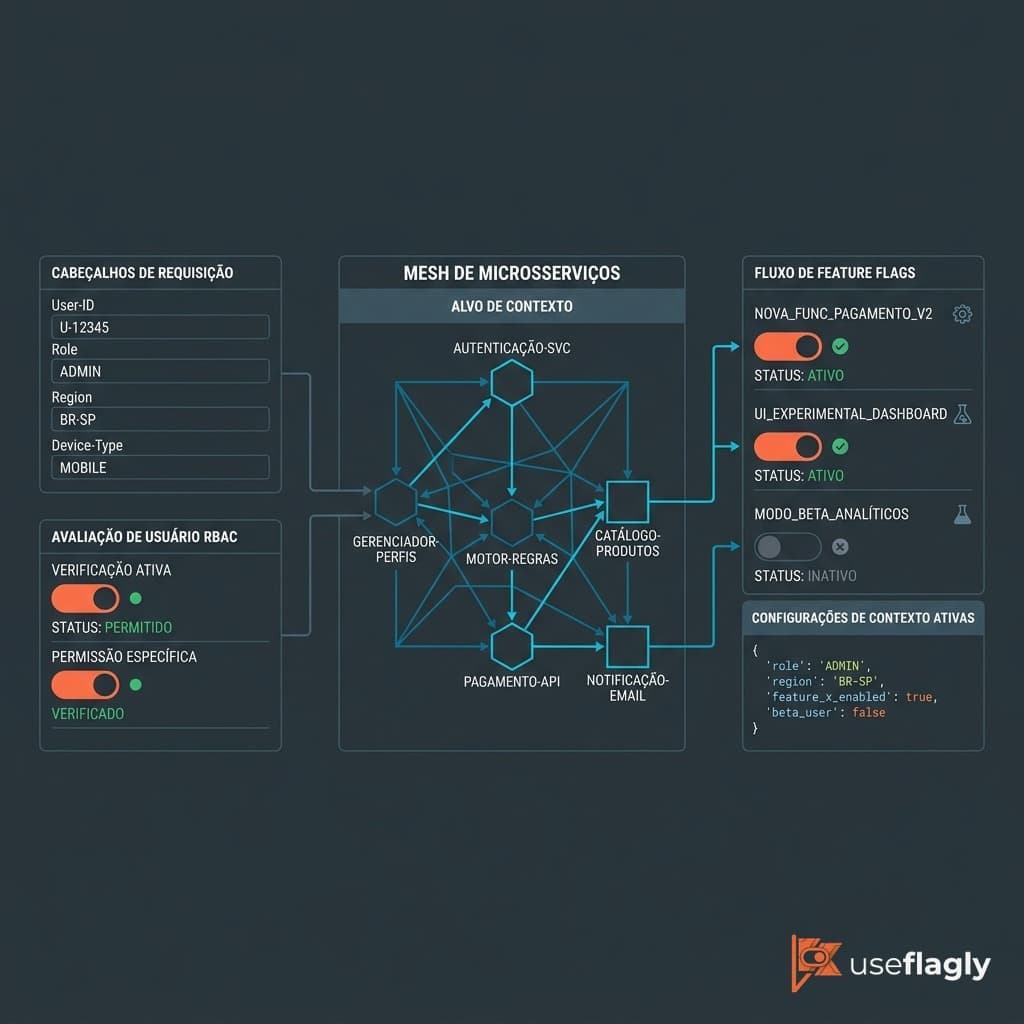
A reestruturação arquitetural iniciou-se com a padronização do SDK do UseFlagly no núcleo dos microsserviços da aplicação. Em vez de avaliar flags por simples valores booleanos globais, a engenharia adotou a avaliação por contexto de requisição. Cada requisição interna carrega metadados padronizados via headers, incluindo tenant ID, nível de permissão (RBAC), e um atributo específico indicando se o chamador pertence ao grupo de engenharia ou auditoria automatizada.
Com essa governança estabelecida, a estratégia de rollout direcionado foi configurada no painel de controle. O fluxo de escrita do novo motor de cálculo transacional foi protegido por uma Feature Flag que intercepta o payload: se a requisição vier de um contexto de teste autorizado, o sistema executa o novo algoritmo gravando o estado em tabelas de shadow writing devidamente segregadas, sem disparar efeitos colaterais nos tópicos de mensageria pública. Para o tráfego regular de clientes, a flag retorna inativa em sub-milissegundos via avaliação local em memória.
Todo esse controle foi implementado com faturamento 100% em Reais (BRL), permitindo previsibilidade orçamentária total e suporte técnico especializado em português diretamente alinhado à equipe de SRE. A infraestrutura de Kill Switch instantâneo do UseFlagly foi integrada aos alertas do APM, garantindo que qualquer anomalia de latência reverta a rota de código em menos de 100 milissegundos sem necessidade de rollback de container.
Resultados concretos & métricas alcançadas
🚀 0 incidentes de contaminação de banco em 12 meses
- ⚡ -88% de tempo médio para validação final de releases
💰 Redução de 55% em custos operacionais frente a ferramentas em USD
A mudança de paradigma eliminou por completo os incidentes de corrupção ou vazamento de dados de teste para clientes reais. O tempo médio gasto entre a finalização do código e sua homologação definitiva caiu de semanas para poucas horas, já que a validação passou a ocorrer em tempo real sob condições reais de carga de rede, sem comprometer a estabilidade do cluster.
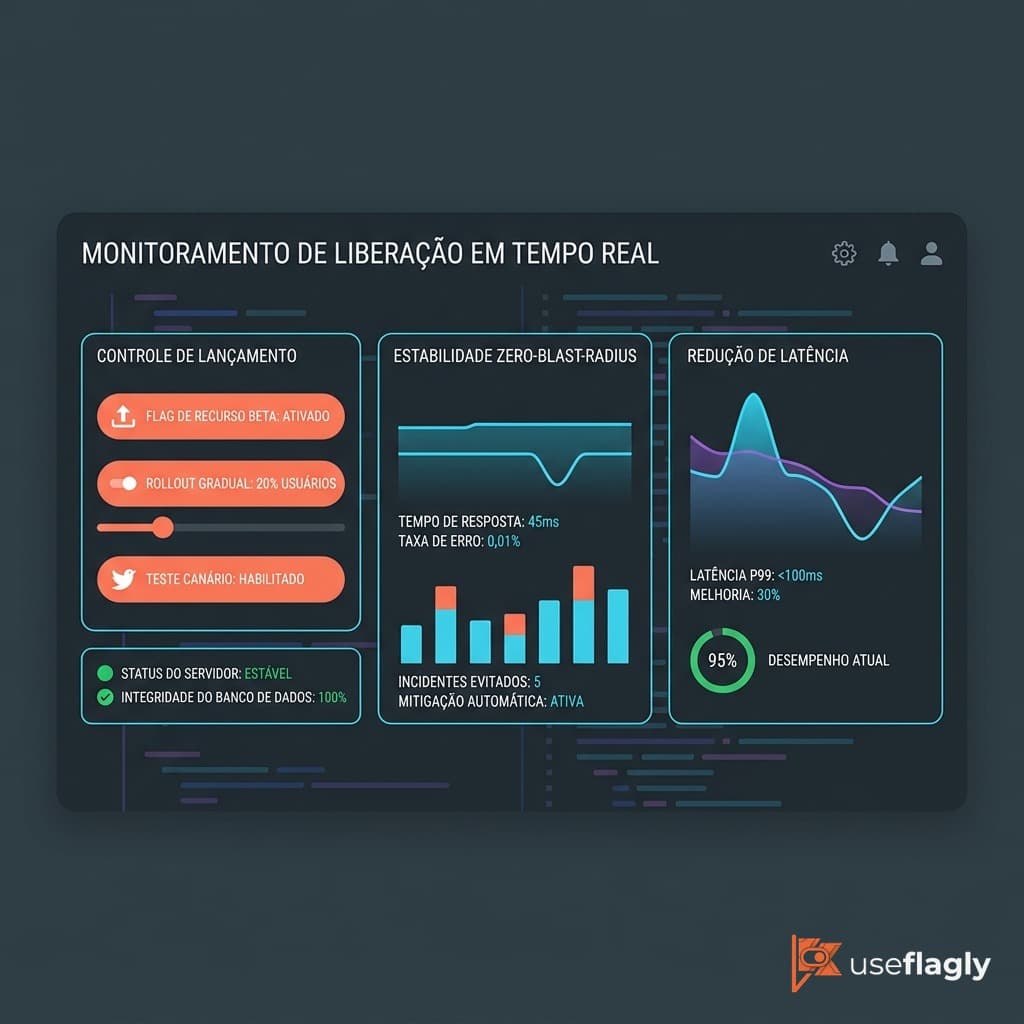
Os plantões de deploy noturnos deixaram de existir. Os desenvolvedores passaram a subir artefatos compilados no meio do expediente comercial através de práticas de Trunk-Based Development, ativando as regras apenas para si mesmos e para baterias de testes end-to-end antes de iniciar a abertura percentual gradativa (Canary Release) para o público geral.
Financeiramente, a migração para o UseFlagly conferiu total controle orçamentário. Ao eliminar faturas em moeda estrangeira atreladas ao dólar e surpresas tributárias de IOF, a engenharia pôde calcular com precisão seu retorno de investimento através do simulador em useflagly.com.br/simulador, comprovando a sustentabilidade do modelo operacional para a diretoria executiva.
Lições práticas para replicar no seu negócio
-
Separe o Deploy da Liberação de Funcionalidade: Subir o código para os servidores precisa ser um evento corriqueiro de infraestrutura via CI/CD, enquanto ligar o recurso para os usuários finais é uma decisão controlada via toggle. Tratar esses dois passos como um único evento é a maior causa de instabilidade em produção.
-
Padronize os Metadados de Contexto nos SDKs: Nunca dependa de verificações binárias genéricas para rotinas críticas de backend. Injete identificadores estruturados de requisição, papéis de usuário (RBAC) e tags de isolamento sintético diretamente no payload avaliado pela flag para direcionar a execução com precisão cirúrgica.
-
Implemente Kill Switches Automatizados: Conecte suas métricas de APM e observabilidade aos gatilhos de controle de flags. Se uma nova query gerar contenção em banco de dados ou picos inesperados de CPU, desative a flag remotamente em tempo real sem precisar recompilar ou fazer novos deploys.
Modernize a entrega de software do seu time com controle total em tempo real e sem oscilações cambiais. Calcule o retorno de investimento da sua arquitetura no useflagly.com.br/simulador ou crie sua conta gratuita no UseFlagly agora mesmo no plano Hobby sem precisar de cartão de crédito.
Pronto para testar Feature Flags na prática?
Crie sua conta grátis no UseFlagly em 2 minutos e comece a controlar lançamentos, testes A/B e kill-switches sem precisar de novo deploy.
✓ 100% Gratuito no Plano Hobby • 25.000 requisições inclusas • Sem cartão de crédito